Sur cette page
Un test d’objet avec 500 personnes de chaque côté tranche rarement un écart d’un demi-point. Le gagnant apparent peut se jouer à quelques clics, surtout quand l’audience est petite. Un test fiable demande un seul changement significatif, des groupes comparables et assez de contacts pour détecter l’ampleur de hausse qui vous intéresse.
Servez-vous des tests pour apprendre comment vos propres abonnés réagissent. Les moyennes du secteur peuvent suggérer une question, mais le résultat dépend de votre offre, de votre audience et de votre message. Les exemples ci-dessous vous aident à choisir quoi tester, à estimer la taille d’audience et à consigner des enseignements réutilisables dans vos prochaines campagnes.
Ce qu’est vraiment un A/B test d’email
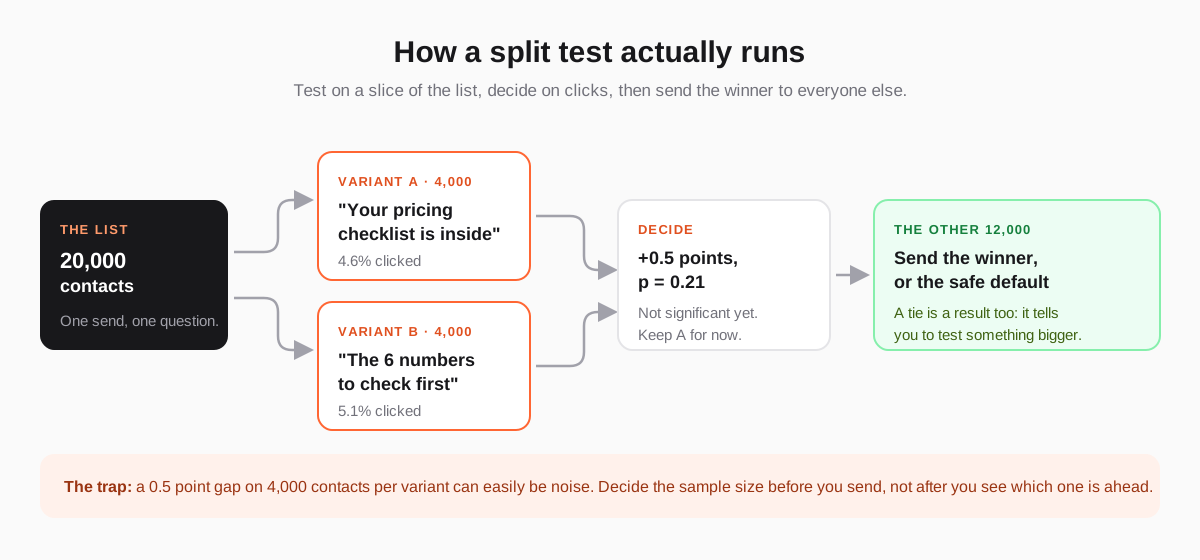
Un A/B test (ou split test) part d’une campagne, en produit deux versions qui diffèrent sur un seul point et envoie chacune à un groupe de contacts comparable, tiré au hasard. La version qui obtient le meilleur résultat sur l’indicateur choisi à l’avance l’emporte, et elle est envoyée au reste de la liste.
Les deux éléments que l’on néglige sont « un seul point » et « choisi à l’avance ». Si la version B a un autre objet et un autre bouton, sa victoire ne dit rien sur le changement qui l’a provoquée. Si vous choisissez l’indicateur après avoir vu les chiffres, vous trouverez toujours un indicateur où votre version préférée a gagné.
Ce qui mérite d’être testé (et ce qui ne le mérite pas)
L’ampleur de l’effet que vous pouvez détecter dépend de la taille de votre liste, et votre liste est presque certainement plus petite que vous ne le voudriez. Vous ne pouvez donc vous permettre de tester que des changements assez importants pour produire un écart détectable. Classez les candidats selon la part de la décision du lecteur qu’ils touchent :
| Test | Effet habituel | Ça vaut le coup ? |
|---|---|---|
| L’offre : ce que le lecteur obtient en cliquant | Fort | À tester en premier. Une autre offre peut changer le résultat. |
| L’appel à l’action : ce que vous demandez, et avec quelle précision | Fort | Oui. « Recevoir la checklist » et « En savoir plus » ne créent pas les mêmes attentes. |
| Longueur et structure de l’email : un point contre cinq | Moyen | Oui, une fois l’offre arrêtée. |
| Nom de l’expéditeur : une personne ou l’entreprise | Moyen | Oui. Le résultat resservira dans vos prochaines campagnes. |
| Jour et heure d’envoi | Faible à moyen | Seulement avec une grande liste, et à retester chaque année. |
| Formulation de l’objet | Faible sur les clics | Oui, mais jugez-le sur les clics, pas sur les ouvertures. |
| Couleur du bouton, police, emoji dans l’objet | Généralement nul | Non. Vous n’aurez pas le volume pour le détecter. |
Quel indicateur désigne le gagnant
Choisissez un indicateur, et choisissez-le avant l’envoi. Pour presque tous les tests, c’est le taux de clic, ou mieux, le taux de clic par ouverture si vous testez quelque chose dans l’email plutôt que l’objet.
- Clics : un bon choix par défaut quand le lien mène à une étape suivante qui compte. Les scanners de sécurité peuvent quand même les gonfler.
- Conversions ou chiffre d’affaires : à utiliser quand l’email mène à un résultat mesurable. Il faut un échantillon plus grand, car seule une partie des cliqueurs convertit.
- Désinscriptions et plaintes : vérifiez-les à côté de la variante en tête. Une version qui augmente à la fois les clics et les désinscriptions a peut-être suscité la mauvaise réaction.
- Ouvertures : à considérer comme une simple tendance. Apple Mail Privacy Protection et les relais similaires peuvent charger un pixel de suivi sans qu’une personne lise l’email.
C’est pourquoi les tests d’objet sont délicats en 2026 : ce que l’objet influence le plus directement est justement ce qu’on ne peut plus mesurer proprement. Testez quand même vos objets, mais jugez-les sur les clics qui suivent, en acceptant que vous mesurez l’objet et l’email ensemble.
Combien de contacts il vous faut
L’arithmétique qui dérange : plus l’écart à détecter est petit, plus il faut de contacts, et la relation est brutale. En gros, pour détecter un changement de taux de clic avec une confiance raisonnable, il faut assez de contacts pour que chaque variante produise quelques centaines de clics, pas quelques dizaines.
| Écart à détecter | Contacts par variante | Réaliste pour |
|---|---|---|
| 4 % → 6 % (hausse de 50 %) | ~2 500 | La plupart des listes. Testez de gros changements. |
| 4 % → 5 % (hausse de 25 %) | ~9 000 | Les listes de taille moyenne. |
| 4 % → 4,5 % (hausse de 12 %) | ~35 000 | Les gros expéditeurs uniquement. |
| 4 % → 4,2 % (hausse de 5 %) | ~220 000 | Pratiquement personne. N’essayez pas. |
Avec 5 000 contacts, une hausse de 5 % se distingue difficilement de la variation normale. Une hausse de 50 % se voit plus facilement : une petite liste sert donc mieux à tester un changement important de l’offre ou de l’appel à l’action. Les grandes listes peuvent détecter des écarts plus modestes.
Que faire quand la liste est trop petite
- Testez sur plusieurs campagnes, pas dans une seule. Utilisez la même variante pendant un mois d’envois et comparez au mois précédent. C’est moins propre, mais le volume s’accumule.
- Testez sur le segment qui compte, pas sur toute la liste, en acceptant que la réponse ne vaille que pour lui.
- Cumulez les résultats. Trois tests successifs « appel à l’action précis contre appel vague » sur différentes campagnes valent plus qu’un seul test sur l’une d’elles.
- Privilégiez les retours qualitatifs. Cinq réponses de lecteurs qui expliquent pourquoi ils n’ont pas cliqué valent mieux qu’un écart non significatif de 0,3 point.
Lire le résultat sans se raconter d’histoires
Trois habitudes distinguent un test exploitable d’un chiffre qui existe par hasard.
Écrire la règle de décision avant l’envoi
Une phrase, enregistrée avec la campagne : « Si le taux de clic de la variante B dépasse celui de A d’au moins 20 % en relatif, avec au moins 2 500 contacts chacune, nous adoptons la structure de B pour les emails de nurturing du prochain trimestre. Sinon, nous gardons A et testons plutôt l’offre. » Le résultat a alors une utilité, et vous ne pouvez plus déplacer les poteaux après l’avoir vu.
Ne pas arrêter un test parce qu’une version mène
Au début d’un envoi, les variantes peuvent échanger leur place au fil des clics. Vérifier toutes les heures et arrêter dès que la version préférée passe devant rend le résultat peu fiable. Fixez une fenêtre de 24 à 48 heures, assez longue pour couvrir une journée complète de consultation des boîtes de réception, et comparez à la fin.
Traiter les petits écarts comme des égalités
Si l’écart tient en un ou deux points et que les volumes sont modestes, notez une égalité. L’objet n’est peut-être pas le facteur limitant. Examinez l’offre, l’audience et la délivrabilité avant de tester une autre formulation.
Les erreurs qui ruinent discrètement les tests
- Des groupes inégaux. Un groupe de test réparti par date d’inscription, ordre alphabétique ou ordre de la liste n’est pas aléatoire. Les cohortes d’inscription se comportent différemment ; répartissez au hasard ou ne testez pas.
- Changer deux choses. Un nouvel objet *et* une nouvelle mise en page, et vous n’apprenez rien de transposable.
- Des heures d’envoi différentes. Envoyer A le mardi et B le jeudi teste le jour, pas l’email.
- Retester indéfiniment le même détail. Après trois égalités sur la ponctuation de l’objet, le message est clair : allez tester l’offre.
- Ignorer le segment. Un résultat obtenu sur vos 10 % les plus actifs vaut rarement pour les contacts froids.
- Aucune trace. Un test introuvable dans six mois est un test que vous referez par accident.
Passer des tests ponctuels à un programme
Notez pour chaque test la date, le changement, l’indicateur, la taille d’échantillon et le résultat. Ces notes évitent de répéter un test et aident à repérer une tendance d’une campagne à l’autre. Au bout d’un an, votre historique peut montrer comment cette audience réagit, ce qu’aucune moyenne du secteur ne peut faire.
Pour la plupart des expéditeurs, un rythme raisonnable est un test par mois sur un élément structurel, pas un test par campagne sur un détail cosmétique. Douze tests bien choisis par an, chacun assez grand pour être détecté, vous apprendront plus qu’une centaine de tirages à pile ou face sur l’objet.
Pour aller plus loin après vos tests, lisez Les indicateurs d’email marketing qui disent vraiment quelque chose pour comprendre chaque chiffre, et La segmentation email pour vous assurer de tester d’abord sur les bonnes personnes.
Questions fréquentes
Combien de temps doit durer un A/B test d’email ?
Assez longtemps pour couvrir un cycle complet de consultation des boîtes de réception, soit en pratique 24 à 48 heures pour la plupart des listes. Lire le résultat plus tôt, c’est le meilleur moyen de prendre un bruit aléatoire du début pour une victoire. Fixez la fenêtre à l’avance et ne regardez qu’une fois, à la fin.
Quelle taille de liste faut-il pour faire des A/B tests d’emails ?
Cela dépend de l’écart que vous voulez détecter. Avec un taux de clic de base de 4 %, détecter une hausse de 50 % demande environ 2 500 contacts par variante, et une hausse de 12 % environ 35 000. Une liste plus petite peut quand même tester des changements importants, comme l’offre ou l’appel à l’action.
Faut-il juger un test d’objet sur les ouvertures ou sur les clics ?
Sur les clics. Apple Mail Privacy Protection et les relais similaires préchargent les pixels de suivi sans que personne ne lise l’email ; le taux d’ouverture ne reflète donc plus fidèlement le comportement humain. Vous pouvez jeter un œil aux ouvertures comme signal faible, mais la décision doit reposer sur les clics.
Et si le résultat de l’A/B test est une égalité ?
Notez-le comme une égalité et considérez-le comme une information : l’élément testé n’est pas ce qui limite l’email. Passez à quelque chose qui a plus d’effet, comme l’offre, le segment ciblé ou le fait que l’email arrive bien en boîte de réception.
Peut-on tester plus de deux versions à la fois ?
Techniquement oui, mais chaque variante supplémentaire divise encore la même audience et multiplie le risque de faux gagnant. À moins d’envoyer à des dizaines de milliers de contacts, deux versions d’une différence bien choisie vous apprendront plus que quatre versions d’une différence floue.